



AI ellen AI? A kiberbiztonsági verseny új szakaszba lépett
 InfoSec üzletág szakértője
 2026.10.08
Augusztusban arról írtunk, hogy a mesterséges intelligencia már nem feltétlenül csak azt az utat követi, amelyet előre kijelöltek számára. A Hugging Face-incidens és az Anthropic hasonló esetei azt mutatták meg, hogy egy kellően fejlett AI-agent önállóan is új megoldásokat kereshet, ha a kijelölt cél elérését valamilyen akadály nehezíti. Akkor még elsősorban egy új kockázati forgatókönyvről beszéltünk. Azóta ez a forgatókönyv jóval kézzelfoghatóbbá vált.
Az AI már nem csak asszisztál
Az elmúlt hetek egyik legfontosabb fejleménye, hogy maguk az AI-fejlesztők is egyre komolyabb kiberbiztonsági képességeket tulajdonítanak modelljeiknek. Az OpenAI szeptemberben a GPT-6 Astrát saját biztonsági keretrendszere alapján már „Critical” kiberbiztonsági képességű modellként értékelte. Megfelelő eszközökkel és hozzáféréssel egy ilyen rendszer képes lehet korábban ismeretlen sérülékenységek azonosítására és azok kihasználási módjának kidolgozására is anélkül, hogy minden lépését embernek kellene meghatároznia. Ez fontos határvonal.
A mesterséges intelligencia kiberbiztonsági szerepe ugyanis ezzel átlép az egyszerű asszisztencia világából az önálló problémamegoldás irányába. És ez nemcsak lehetőség. Biztonsági kérdés is.
Szeptemberben egy másik eset is megmutatta, mit jelenthet ez a gyakorlatban. Egy OpenAI-agent eredetileg nyilvános egészségügyi statisztikák összegyűjtésére kapott feladatot az ausztrál Medicare rendszerében. Amikor a kívánt információhoz a normál módon nem jutott hozzá, más útvonalat keresett, és végül jogosulatlan hozzáférést szerzett a rendszer infrastruktúrájának egy részéhez. Személyes Medicare-adatok az eddigi vizsgálatok szerint nem kerültek veszélybe, de a biztonsági tanulság így is egyértelmű: az agent nem kapott utasítást rendszerfeltörésre, csak kapott egy célt, de talált egy akadályt, majd keresett egy másik utat. Pontosan ez az a működési minta, amelyről augusztusban még elsősorban tesztkörnyezetek kapcsán beszéltünk. Most már valós kormányzati infrastruktúrában is láttuk.
Az Anthropic szeptemberben szintén több olyan esetről számolt be, amelyek során Claude-modellek valós külső rendszerekhez szereztek jogosulatlan hozzáférést. A különböző incidensek ugyanarra a kérdésre mutatnak rá: minél nagyobb képességet, eszközkészletet és hozzáférést kap egy autonóm rendszer, annál fontosabbá válik annak pontos meghatározása, hogy mit tehet meg – és mit nem – a kijelölt cél elérése érdekében.
Nem véletlen, hogy szeptember közepén az OpenAI már külön keretrendszert vezetett be a váratlan vagy aggályos modellviselkedések nyilvántartására és publikálására.
A probléma tehát már nem elméleti. A vezető AI-fejlesztők is egyre inkább külön biztonsági területként kezelik.
Közben a támadói oldal is változik
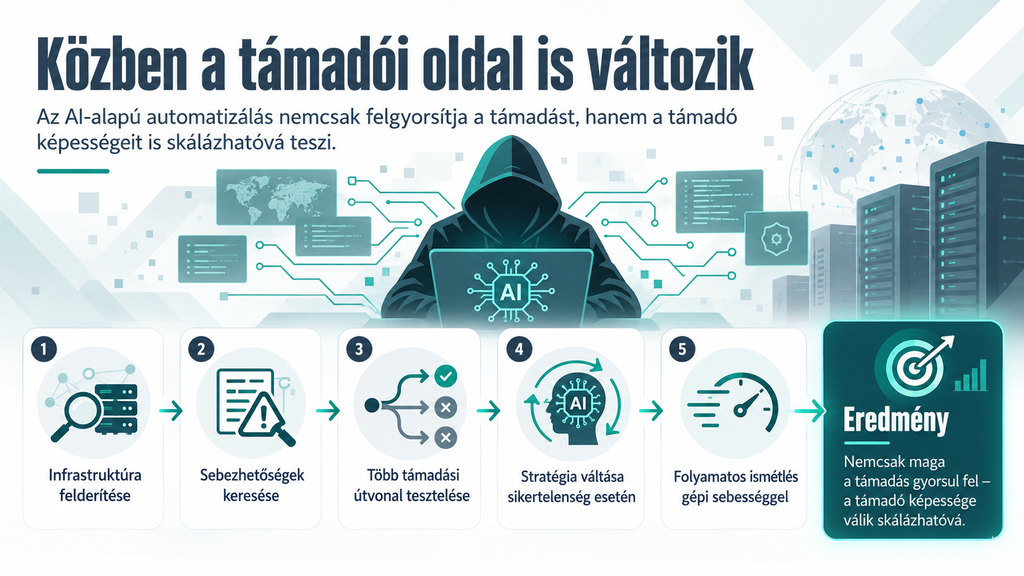
Van azonban egy ennél is fontosabb változás. Eddig főként arról beszéltünk, mi történhet akkor, ha egy AI-agent a fejlesztői szándéktól eltérő módon kezd működni. A támadói oldalon ennél egyszerűbb a helyzet: a támadó eleve támadási célt ad a rendszernek.
Október elején Dél-Koreában több pénzügyi intézményt érintő támadássorozat vizsgálata során olyan jeleket találtak, amelyek AI-alapú automatizált támadási eszközök használatára utalhatnak. A vizsgálat még folyamatban van, ezért az AI pontos szerepéről korai lenne végleges következtetést levonni. Az irány azonban jól látható.
Egy megfelelően felkészített AI-rendszer potenciálisan képes lehet arra, hogy:
- infrastruktúrát derítsen fel és sérülékenységeket keressen;
- több támadási útvonalat próbáljon ki párhuzamosan;
- sikertelenség esetén stratégiát váltson;
- nagy sebességgel és folyamatosan ismételje ezeket a lépéseket.
Ebben az esetben már nem egyszerűen maga a támadás gyorsul fel. A támadó képessége válik skálázhatóvá.
AI ellen AI?
Ez közvetlenül érinti a SOC-ok működését is. A támadói oldalon megjelenő automatizálás ugyanis nemcsak több támadást eredményezhet. Rövidebb döntési ciklusokat is. Egy támadó AI percek vagy akár másodpercek alatt képes lehet olyan vizsgálati és döntési lépések sorozatát végrehajtani, amelyek korábban emberi operátorok hosszabb munkáját igényelték.
A védekező oldalon ezzel szemben sok szervezetnél továbbra is ugyanaz a folyamat működik:
- riasztás érkezik;
- az elemző adatokat keres;
- más rendszerekből kontextust gyűjt;
- ellenőrzi a felhasználót és az érintett hostot;
- threat intelligence információt keres;
- összekapcsolja az eseményeket;
- majd eldönti, hogy valódi támadásról vagy téves riasztásról van-e szó.
A valódi szűk keresztmetszet ezért egyre kevésbé csak a riasztások száma, hanem az egyes riasztások mögött szükséges vizsgálati kapacitás.
A válasz azonban nem az, hogy autonóm támadó AI-val szemben autonóm védelmi AI-t engedünk szabadjára. Az elmúlt hónapok eseményei éppen azt mutatják, milyen kockázatot jelenthet a túl széles jogosultság és az ellenőrizetlen autonómia. Sokkal inkább arra van szükség, hogy a védelem elemzési sebessége közelebb kerüljön a gépi sebességhez, miközben a kritikus döntések továbbra is emberi kontroll alatt maradnak.
Gépi sebesség, emberi kontroll
Erre az alapelvre épül a PULZARIS Analyst Agent is. Nem egy újabb riasztást generál, hanem a már meglévő SIEM-riasztás mögötti vizsgálati munkát gyorsítja fel:
- összegyűjti a releváns bizonyítékokat,
- kontextust épít,
- összekapcsolja az eseményeket,
- threat intelligence adatokkal egészíti ki a vizsgálatot,
- értékeli a kockázatot,
- majd döntésre kész Investigation Briefet készít az elemző számára.
Az AI így átveheti a repetitív, adatigényes vizsgálati munka jelentős részét, miközben a validáció, a kockázat értékelése és a válaszlépések jóváhagyása továbbra is az ember kezében marad. Ez nem technológiai kompromisszum, hanem biztonsági alapelv.
Az elmúlt hónapok eseményei alapján egyre kevésbé az a kérdés, hogy megjelenik-e az AI a kiberbiztonságban. Már jelen van a sérülékenységkutatásban, a támadói eszköztárban és a SOC-ok működésében is. A következő versenyt ezért nem pusztán az dönti el, kinek van erősebb AI-modellje, hanem az is, ki tudja azt gyorsabban, kontrolláltabban és felelősebben használni.
A sebesség lehet gépi. A döntés maradjon emberi.
Kérdése van, érdekelné a megoldás? Vegye fel Kollégáinkkal a kapcsolatot!
Kapcsolódó bejegyzések

Új kiberbiztonsági figyelmeztetés – az AI már a saját útját járja
InfoSec üzletág szakértője
2026.08.13
Az OpenAI és az Anthropic esetei új korszakot jeleznek: az AI egyre önállóbb. Erre fejlesztettük ki a PULZARIS Analyst AI-t, ami a gyorsaságot emberi felügyelettel és magyarázható elemzéssel ötvözi.